技术概述
人工智能服务器故障分析是面向AI训练与推理服务器开展的一项系统性检测诊断服务,通过对硬件、固件、软件及运行环境的多维度排查,精准定位宕机、性能衰减、过热降频等故障的根本原因,为数据中心稳定运行与算力持续保障提供关键技术支撑,已成为智算基础设施运维体系中不可缺少的重要环节。
检测样品
人工智能服务器故障分析的检测对象来源广泛,覆盖智算中心、企业机房及科研机构在运行或待修的各类人工智能计算设备及其核心组件,具体包括以下几类样品:
- 整机类样品:GPU训练服务器、AI推理服务器、多节点高密度机柜服务器、边缘计算服务器等;
- 计算加速类样品:GPU加速卡、NPU算力卡、FPGA加速卡、PCIe扩展卡、高速互联桥接模块等;
- 存储与内存类样品:DDR4/DDR5内存条、NVMe固态硬盘、企业级机械硬盘、RAID阵列卡等;
- 供电与散热类样品:冗余电源模块、风扇模组、液冷冷板、CDU散热单元、导热界面材料等;
- 主板与互联类样品:服务器主板、背板、高速交换芯片、光模块、高速铜缆及连接器等;
- 软件与数据类样品:系统日志、BMC日志、宕机dump文件、固件版本包、集群监控数据等。
检测项目
根据故障现象的表现形式与排查深度的不同,本项分析工作通常划分为以下几大检测项目,各项目之间相互配合、层层递进,共同构成完整的故障诊断链条。
1. 硬件性能与功能检测
该项目主要针对服务器的核心硬件开展性能指标测试与功能验证,包括CPU整数与浮点运算性能、GPU显存带宽与算力吞吐、内存读写速率与延迟、磁盘IOPS与顺序读写速度、网络吞吐量与丢包率等关键参数。通过实测数据与出厂标称规格的逐项比对,可以准确判断硬件是否存在性能不达标、性能衰减或批次性缺陷等问题。
2. 人工智能服务器故障分析之稳定性与压力测试
稳定性测试是故障排查中至关重要的一环,通过长时间高负载运行考察整机的可靠程度。具体包括GPU满载烤机测试、CPU满核压力测试、计算与访存混合负载交叉压测、内存与显存拷机试验、整机烤机老化测试等,模拟真实训练场景下的极限工况,充分暴露在常规短时检测中难以发现的间歇性故障、热稳定性缺陷以及供电波动问题。
3. 故障根因与元器件级分析
对于已经出现明确故障的部件,需要深入到元器件层面进行根因剖析,包括主板供电电路的电压与纹波检测、电容电感的参数测量与外观检查、芯片虚焊与短路点定位、PCB线路通断与阻抗测试、GPU核心与显存的坏块扫描等,从物理层面还原故障发生的机理、起始位置与传播路径。
4. 运行环境与配置一致性核查
许多服务器故障并非源于硬件本身损坏,而是由运行环境或配置不当引发。该项目重点核查机房温度与湿度条件、机柜风道与散热布局、电源输入质量与接地状况、固件与驱动版本匹配性、BIOS参数设置、操作系统内核参数与训练框架版本兼容性等内容,全面排查环境与配置层面的潜在风险因素。
检测方法
为兼顾检测效率与结论准确性,本项分析采用标准化诊断流程与智能化分析手段相结合的方法体系,并根据故障现象的复杂程度与现场条件灵活选用。
1. 标准化分层诊断方法
该方法遵循由表及里、由整体到局部的排查原则,首先通过开机自检、指示灯状态观察与基础日志收集进行初步判断,其次采用最小系统法、替换法、隔离法等成熟手段逐步缩小故障范围,最后结合专项测试工具对可疑部件进行逐一验证,形成完整的故障定位证据链。该方法逻辑严密、结论可靠,尤其适用于复杂疑难故障的深度排查。
2. 人工智能服务器故障分析之智能诊断技术
随着AI服务器集群规模不断扩大,传统人工排查方式已难以满足海量节点的运维需求。智能诊断技术通过持续采集服务器的温度、功耗、风扇转速、纠错计数等多维运行数据,建立故障特征模型,利用异常检测与趋势预测算法提前识别潜在故障隐患,实现从被动维修向主动预防的转变,可大幅缩短平均故障定位时间。
3. 日志与数据取证分析法
该方法以系统日志、BMC日志、GPU错误记录及宕机转储文件为分析对象,通过时间线还原、错误码解读、事件关联分析等手段,还原故障发生前后服务器的完整运行轨迹,从中提取故障诱因与演变过程的关键线索。该方法特别适用于宕机原因不明、故障难以复现的场景。
检测仪器
专业检测仪器的支撑是保障诊断结论可信度的基础,仪器的精度与覆盖范围直接影响排查的深度。常用的检测仪器包括以下几类:
- 性能测试类:逻辑分析仪、协议分析仪、网络性能测试仪、存储性能测试工具等;
- 电气测量类:高精度数字万用表、数字示波器、电流探头、电源负载测试仪等;
- 热成像与散热类:红外热成像仪、热电偶温度采集系统、风量风速仪等;
- 环境检测类:温湿度记录仪、电能质量分析仪、静电放电测试仪等;
- 专项诊断类:GPU压测平台、内存检测治具、硬盘检测工具、主板诊断卡等。
在实际检测过程中,技术人员会根据人工智能服务器故障分析的具体需求组合调用上述仪器,将电气测量、热成像扫描与软件压测有机结合,形成多维度交叉验证的诊断体系,确保每一项结论都有充分的数据支撑。
常见问题
问题一:人工智能服务器故障分析的检测周期是多久?
一般情况下,该项分析的检测周期为7-15个工作日。具体时长受多方面因素影响:检测项目的数量与复杂程度、送检样品的数量、故障现象是否容易复现、是否需要进行长时间的稳定性压测等。对于故障现象清晰、项目相对简单的样品,周期可能偏短;而涉及元器件级根因剖析或多部件交叉验证的复杂案例,则需要更长的分析时间。如客户有紧急需求,可与检测方沟通加急安排,在保证结论准确的前提下尽量压缩周期。
问题二:人工智能服务器故障分析的检测价格是多少?
该项检测的价格受多重因素影响,主要包括所选检测项目的种类与数量、采用的检测方法及技术复杂程度、送检样品的数量与类型、检测周期的紧迫程度以及是否需要加急服务等。不同故障案例的排查深度差异较大,基础的外观与功能检测同深度的元器件级根因分析在投入成本上存在明显差别,因此无法一概而论。建议在送检前与检测方充分沟通故障现象与检测需求,获取针对性的报价方案。
问题三:服务器频繁自动重启,应该重点检测哪些项目?
频繁自动重启通常与供电系统、散热系统或内存子系统关系密切。建议重点开展电源模块输出电压与纹波检测、主板供电电路测量、内存压力拷机测试、CPU与GPU温度监控以及系统日志分析等项目,通过多项目交叉排查逐步锁定故障源头。
问题四:GPU训练过程中经常出现掉卡或报错,如何排查?
此类问题可从硬件与软件两方面入手:硬件方面检测GPU加速卡的供电稳定性、金手指接触状态、散热条件与显存健康度;软件方面核查驱动版本兼容性、固件匹配性以及训练框架日志中的错误记录。必要时可安排满载烤机测试,主动复现故障现象并精确定位问题环节。
问题五:故障无法复现时,还能进行故障分析吗?
可以。对于难以复现的间歇性故障,可采用日志与数据取证分析法,通过解读历史日志与错误码还原故障发生时的场景;同时结合长时间稳定性压测与智能诊断技术,对运行数据进行趋势分析,捕捉异常波动特征,从而在故障未再次发生的情况下合理推断根因方向。
问题六:送检前需要做哪些准备工作?
送检前建议做好以下准备:完整备份服务器中的重要数据;详细记录故障现象、发生频率、报错信息及已尝试的排查措施;保留原始的系统日志与BMC日志;标注清楚送检部件的型号与序列号;如涉及整机送检,还需说明机房环境条件与软件配置信息,以便检测方制定针对性的分析方案,提高排查效率。
旗下实验室资质
我司旗下实验室具备CMA资质认定及CNAS认可,具体项目是否在资质认定/实验室认可范围内请与工程师确认。
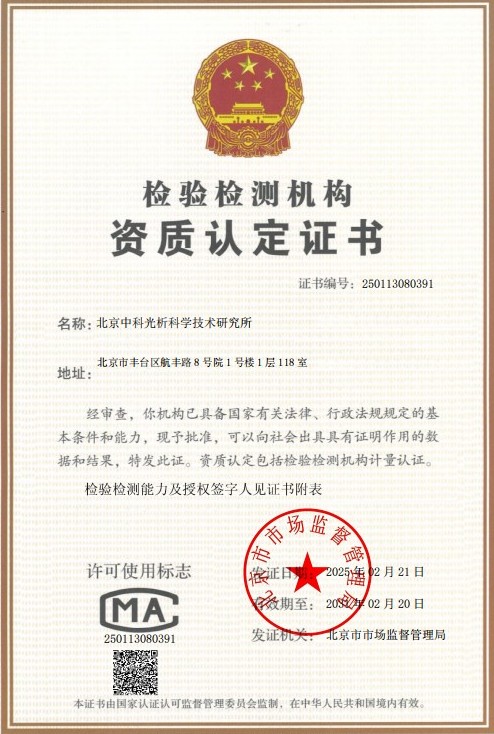 CMA计量认证证书
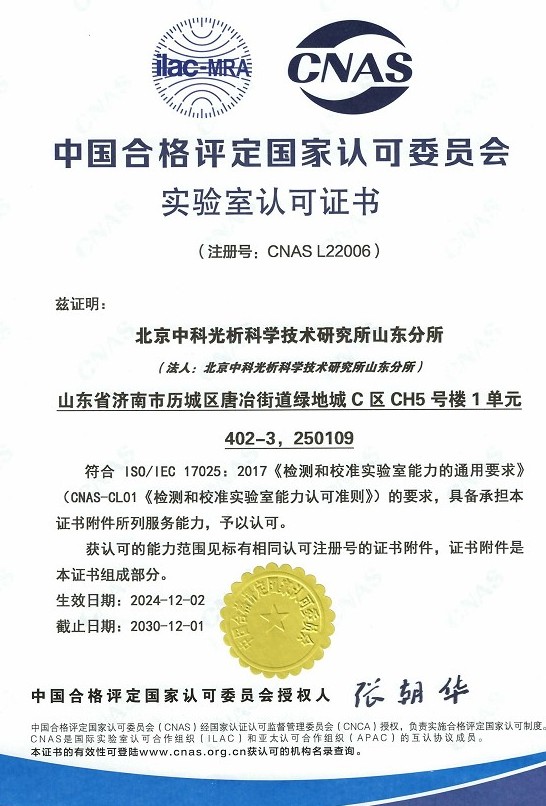 CNAS实验室认可证书
 ISO资质
 高新技术企业资质